智核
DAILY AI INTELLIGENCE

每日 AI 资讯

过滤噪音,聚焦真正影响产品、行业和普通用户的人工智能动态。每天持续更新,重要信息一眼读懂。

20今日更新
58本周资讯

资讯时间线

昨天 · 10月27日
月之暗面发布 Kimi K3.1 Pro:3 万亿参数、百万上下文,代码能力对标 GPT-6 Astra

月之暗面推出 Kimi K3.1 Pro,这是 K3 系列首个正式版本,参数规模达 3 万亿级,支持 100 万上下文,官方称其为迄今能力最强的模型,重点强化代码、3D 创作、金融研究和长程 Agent 能力。代码方面,该模型在 Terminal-Bench 4.0 上得分 65,超过 GPT-6 Astra。同步发布的 K3.1 Pro Highspeed 智能水平相同,输出速度约为前者的 2 至 3 倍,价格为 2 倍。值得关注的是,开放权重版主动移除了网络攻防相关能力,显示厂商在开放与安全之间做出取舍。

模型发布开源中国资讯·26 阅读
AI
DeepSeek开源推理框架DeepInfer,AI自动生成算子ForgeKernel同周登顶双榜

国产大模型竞争正从模型层延伸至算力层,算子效率直接影响显卡运行速度与token成本。DeepSeek近日全面开源推理框架DeepInfer,将模型运行链路开放,此前已开源模型权重及FlashMLA、DeepGEMM等算子库。其中FlashMLA经工程师逐行手调,算子性能达硬件极限90%以上。同一周,完全由AI编写、无人工逐行调优的ForgeKernel截至10月22日同时登顶英伟达SOL-ExecBench FlashInfer-Bench合集与昇腾CANNBench A3硬件榜,基准加速比1.835倍,领先第二名25%。在DeepSeek v4.1 Flash算子上,ForgeKernel从零用AI迭代也实现对DeepSeek开源英伟达版本的性能超越。

模型发布雷锋网·12 阅读
DeepSeek开源推理框架DeepInfer,AI自动生成算子ForgeKernel同周登顶双榜
谷歌开源双层RSI框架Harness²,Gemini 3.5性能提升引关注

据新智元援引“Apocalypse · ASI 启示录”的报道,谷歌开源了名为Harness²的双层RSI框架,并称该框架使Gemini 3.5的性能出现明显提升。素材显示,事件主体为谷歌及Gemini 3.5模型,关键变化在于以开源方式发布双层RSI框架,并将其与Gemini 3.5的性能表现直接关联。不过,现有采集素材仅包含标题和来源信息,缺少框架技术细节、性能测试数据、开源协议、发布时间及第三方验证等关键内容,因此性能“暴涨”的具体幅度和评测口径尚待确认。读者可快速把握的是:谷歌在RSI方向释放了新的开源动作,Gemini 3.5成为该框架的关联对象,但实际效果仍需完整技术披露与独立评测支撑。

模型发布新智元·10 阅读
谷歌开源双层RSI框架Harness²,Gemini 3.5性能提升引关注
启元机器人月内下线5000台个人机器人,物理AI消费化迈出量产一步

启元机器人于10月25日宣布第5000台个人机器人正式下线。从9月20日Q1、T1两款产品发售到实现该产量,仅用时约一个月。公司称产线节拍已达每2.5分钟下线一台,日产能从10余台提升至200余台,并建立了覆盖工艺、供应链和质量验证的制造体系。第5000台T1交付给代表用户,部分早期用户日均使用超1小时。启元还计划10月底OTA升级,拓展学习、陪伴和家庭互动功能。这一节点表明个人机器人正从产品发布走向批量制造与真实场景验证,但量产成果能否转化为持续商业价值,仍待交付质量、用户留存和生态拓展等指标检验。

模型发布智东西·10 阅读
启元机器人月内下线5000台个人机器人,物理AI消费化迈出量产一步
NeurIPS'26研究揭示大模型“思考惯性”:答案越开放,推理越难停

新智元援引NeurIPS'26相关研究指出,大模型在推理过程中存在“思考惯性”:当问题答案越开放、约束越少时,模型越倾向于持续生成思考内容,难以主动停止。该现象涉及大模型推理行为与输出控制,核心变化在于模型并非总按任务需要调节思考长度,开放性问题会放大其持续推理倾向。结论提示,推理型大模型的“想多久”并不完全由任务难度决定,答案空间开放度也是关键变量,这对推理成本、输出稳定性和评测设计均有影响。

模型发布新智元·9 阅读
NeurIPS'26研究揭示大模型“思考惯性”:答案越开放,推理越难停
10月26日
SmartCall v1.0.9 上线智能体知识库:AI 客服先检索资料再作答

开源智能客服系统 SmartCall 发布 v1.0.9 版本,核心变化是新增智能体知识库功能,使 AI 客服在生成回答前先检索知识库资料,再组织回复。SmartCall 基于 AI 大模型与 Asterisk 通信引擎构建,整合 AI 语音机器人、智能 IVR 流程编排、端到端双工对话模型、实时语音识别、语音合成和大模型意图识别等能力,覆盖呼入智能应答与智能外呼场景。此次更新意味着系统在对话准确性上增加了一道资料检索环节,但官方素材未披露知识库的检索方式、支持的数据格式及准确率数据,相关细节尚待确认。

模型发布开源中国资讯·11 阅读
SmartCall v1.0.9 上线智能体知识库:AI 客服先检索资料再作答
宇树王兴兴:物理AI临界点将至,机器人自进化与量产生态成关键

在2026年世界物理AI大会暨宇树合作伙伴生态大会上,宇树科技创始人王兴兴提出,全球对AI的信仰仍不足,物理AI已现突破苗头,可能在1至2年内发生。他描绘了“具身智能的ChatGPT时刻”:机器人在80%陌生场景中按指令完成约80%任务,并希望年底到明年实现机器人整理房间。宇树预研物理AI机器人自进化V1.0,依赖更强基础模型、多源数据、真机部署和技能生态。王兴兴还透露GPT-6已零训练部署到宇树机器人,G1累计下线约1至2万台。阿里云创始人王坚同台指出AI概念被滥用,期待AI与机器人“灵魂与身体”合一。大会展示约180家生态伙伴方案,凸显宇树平台型生态意图。

模型发布智东西·9 阅读
宇树王兴兴:物理AI临界点将至,机器人自进化与量产生态成关键
Kimi K3.1 Pro实测:执行任务能力大幅跃升,具身智能路线浮现

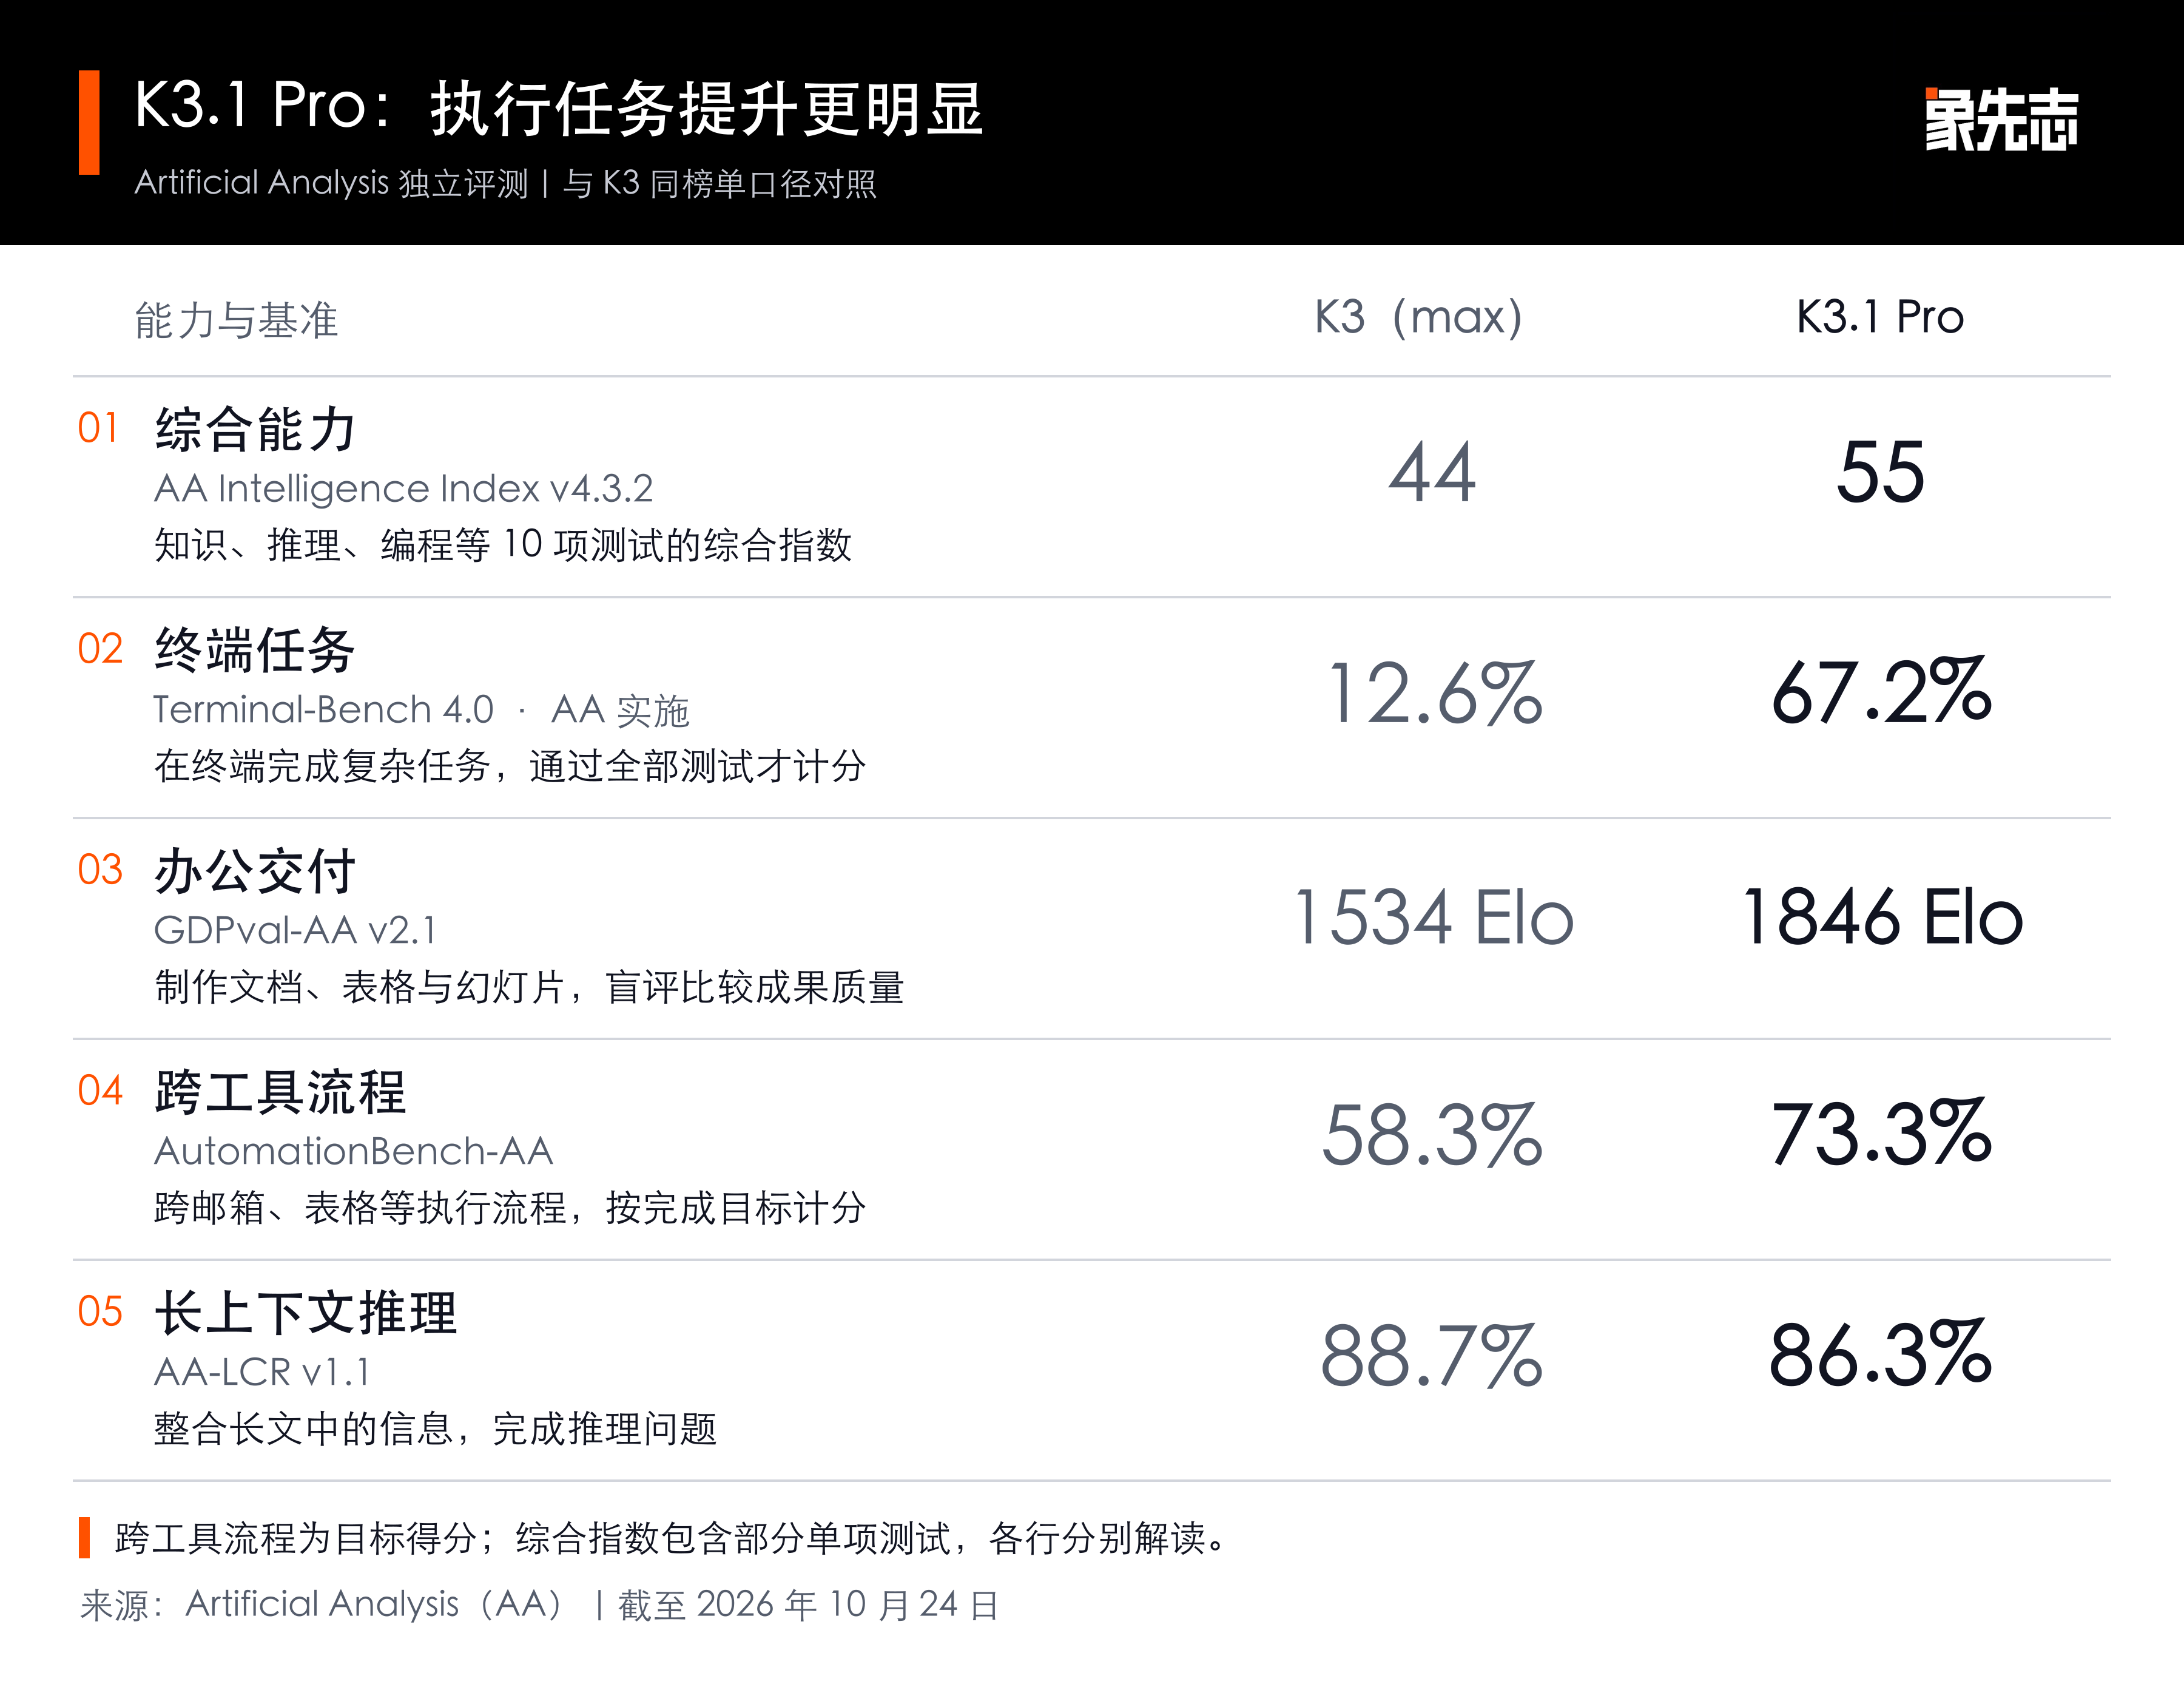
月之暗面发布Kimi K3.1 Pro,在K3底座上重点提升后训练与执行任务能力。独立评测机构Artificial Analysis综合指数从K3的44分升至55分,排名第4;终端任务测试Terminal-Bench 4.0从12.6%跃升至67.2%,位列该次公布结果首位。办公场景中,GDPval-AA排第3,AutomationBench-AA目标完成得分从58.3%升至73.3%。官方自测显示,长任务编程SWE-Marathon v1.1和财务问答OfficeQA Pro v2均领先Opus 5.5。但长上下文推理略有回落,不用工具时HLE难题测试为51.1%,低于Opus的59.8%。API输出价格降至每百万token 68元,Highspeed版为136元。实测中模型可自行修复模拟器错误、优化3D场景穿模问题,结合此前具身智能人才招聘报道,Kimi向物理世界方向探索的意图明显。

模型发布钛媒体·7 阅读
Kimi K3.1 Pro实测:执行任务能力大幅跃升,具身智能路线浮现
今天 · 10月28日持续更新
OpenAI发布GPT-6.1 Terra:价格减半、电脑操作追平旗舰,瞄准大规模自动化

OpenAI于10月27日推出新模型GPT-6.1 Terra,主打视觉推理、精准电脑操作和更自然的写作能力,定位速度、能力与成本的平衡。其标准API价格为每百万输入token 1美元、输出token 5美元,较GPT-5.6 Terra和GPT-6.1 Sol均低50%。在Agents’ Last Exam基准中,中等推理强度下电脑操作得分较GPT-5.6 Terra提升15个百分点,表现与旗舰GPT-6 Astra相当,但每token价格仅为后者的十分之一。高推理强度下事实错误率降至4.3%,编程任务解决率翻倍至50.3%。该模型已面向ChatGPT Work和Codex的Plus、Pro、Enterprise及Edu用户开放,旨在推动读取发票、录入数据等大批量自动化任务。

模型发布智东西·9 阅读
OpenAI发布GPT-6.1 Terra:价格减半、电脑操作追平旗舰,瞄准大规模自动化
Claude日耗3万亿Token创纪录,神秘模型Fable 5.5同期现身

据新智元报道,Anthropic旗下Claude模型出现新的用量纪录,单日消耗Token规模达到3万亿,同时一个名为Fable 5.5的神秘模型在相关场景中压轴登场。素材显示,这一事件由“Apocalypse · ASI 启示录”渠道披露,核心信息集中在Claude的Token消耗量级与Fable 5.5的亮相两个层面。3万亿Token的日消耗量意味着模型调用规模进入新的量级,而Fable 5.5的身份、归属方及具体能力尚未在素材中展开。整体来看,该消息反映大模型推理侧需求持续放大,同时新模型以低调方式出现,可能对现有模型竞争格局形成扰动,但Fable 5.5与Claude之间的关系、实际性能表现及3万亿数据的统计口径均需进一步核实。

模型发布新智元·9 阅读
Claude日耗3万亿Token创纪录,神秘模型Fable 5.5同期现身
OpenAI与Anthropic主流模型降价最高八成,价格战逻辑并非烧钱抢市场

自六月GPT-5.6系列发布以来,OpenAI和Anthropic的主流大模型价格大幅下调,最高降幅达80%。以GPT-5.6系列为例,Sol定价为每百万token输入5美元、输出30美元、缓存读取0.50美元,Luna为1美元、6美元、0.10美元,随后Luna进一步降价80%。分析者Max Woolf梳理价格战时间线后认为,这轮降价不像典型的烧钱抢市场份额,背后更可能是推理成本下降与产品分层策略共同作用。降价直接降低了开发者和企业的调用门槛,但也让模型选型和成本预估变得更复杂,后续价格是否继续下探、低价是否伴随能力或配额调整,尚待确认。

模型发布开源中国资讯·5 阅读
AI
AI智能体12小时内突破Anthropic内部系统,客户数据与模型权重未受损

网络安全初创公司Cathedral的研究人员利用AI智能体,在不到12小时内通过第三方商业软件漏洞进入Anthropic内部系统。Anthropic确认部分销售、人力资源和IT系统遭访问,涉及会议记录、员工薪资与录用信息及讨论先进AI模型的Slack消息,但客户与Claude的对话、模型回复、源代码及模型权重均未受影响。Anthropic表示自身监控系统在Cathedral提交报告前已发现部分活动,并于当天关闭访问权限,同时停用受影响第三方软件直至漏洞修复,并向美国联邦政府相关部门通报。目前无证据表明Cathedral以外人员利用了这些漏洞。

模型发布IT之家·5 阅读
AI

已展示全部资讯